26/07/24 질문 모음
1. AI agent 정의: LLM이 도구와 상태를 이용해 목표를 달성하도록 판단하고 행동하는 시스템입니다.
사용자 목표 입력
↓
해야 할 일 판단
↓
필요한 도구 선택
↓
검색·계산·API 호출·DB 조회
↓
결과 확인
↓
필요하면 다시 실행
↓
최종 답변 또는 업무 완료
2. AI agent 프레임워크 종류
| 프레임워크 | 특징 | 적합 경우 | 난이도 | |
| 1 | LangChain | 모델, 프롬프트, 도구, 검색 등을 쉽게 연결 | 범용 Agent, RAG, 빠른 개발 | 낮음 |
| 2 | LangGraph | 상태·노드·분기·반복을 그래프로 제어 | 복잡한 업무 흐름, 장기 실행, 실제 서비스 | 중상 |
| 3 | 직접 Python 구현 | 반복문, 함수, API 호출로 자체 구현 | 보안·성능·세밀한 제어가 필요한 서비스 | 낮음~높음 |
| 4 | OpenAI Agent SDK | Agent, Tool, Handoff, Guardrail을 간결하게 구현 | OpenAI 모델 중심 서비스 | 낮음 |
| 5 | LlamaIndex | 문서·DB 검색과 RAG에 강함 | 사내 문서, 지식검색 Agent | 중간 |
3. LangChain 과 LangGraph 의 차이
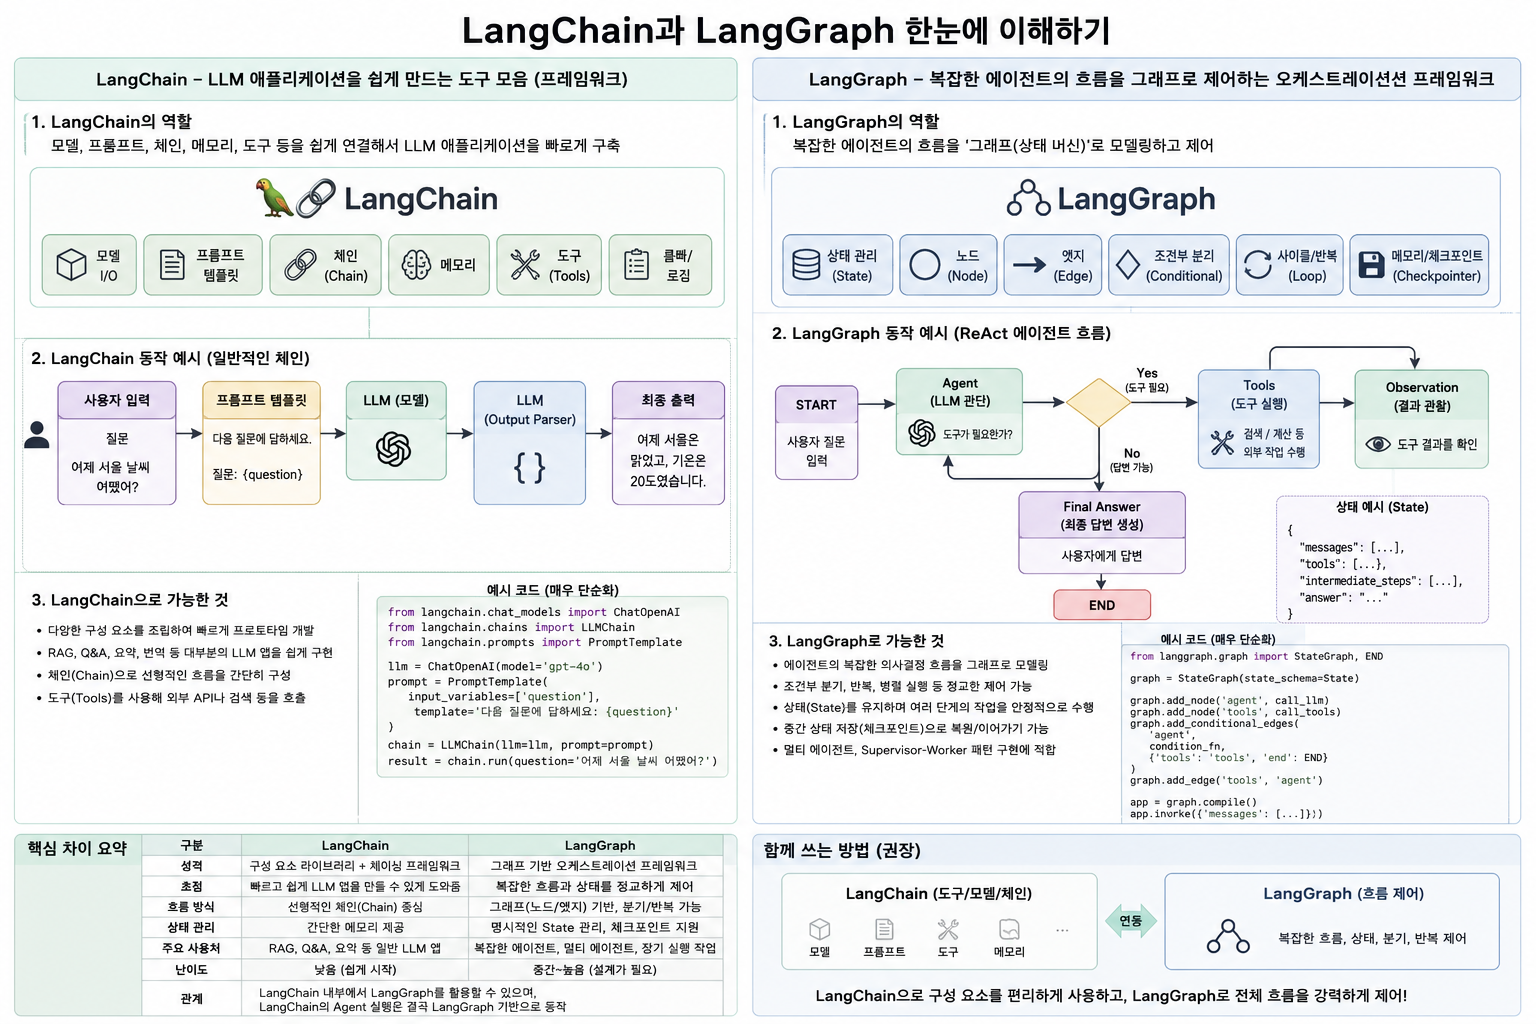
4. AI agent 필수 구성 요소
| 순위 | 구성요소 | 역할 | 예시 |
| 1 | 목표 및 업무 정의 | Agent가 해결할 문제와 완료 조건을 정의 | 최신 에너지 뉴스를 검색하여 중요 기사 5개 요약 |
| 2 | 판단 모델, LLM | 사용자 요청을 해석하고 도구 선택 및 다음 행동을 결정 | GPT, Gemini, Claude, Llama |
| 3 | 도구, Tool | Agent가 실제 행동을 수행하는 함수 | 뉴스 검색, 날씨 조회, DB 검색, 이메일 전송 |
| 4 | 시스템 프롬프트 | Agent의 역할, 규칙, 도구 사용 조건을 정의 | 신뢰 가능한 출처만 사용하고 출처를 표시하라 |
| 5 | 상태, State | 현재 작업 진행 상황과 중간 결과를 저장 | 사용자 요청, 검색 결과, 선택한 기사, 요약문 |
| 6 | 실행 흐름, Workflow | 어떤 순서로 판단하고 도구를 실행할지 제어 | 요청 분석 → 검색 → 검증 → 요약 → 출력 |
| 7 | 메모리, Memory | 이전 대화나 사용자 정보를 저장하고 재사용 | 선호 뉴스 분야, 이전 검색 결과, 사용자 설정 |
| 8 | 외부 지식 연결 | LLM이 모르는 최신 정보나 내부 문서를 제공 | RAG, 웹 검색, 데이터베이스, API |
| 9 | 출력 형식 | 최종 결과가 일정한 구조를 갖도록 제한 | JSON, 표, 보고서, 이메일 |
| 10 | 검증 및 평가 | 결과의 정확성, 완전성, 도구 선택을 평가 | 출처 검증, 환각 검사, 정답률, 성공률 |
| 11 | 오류 처리 | API 실패, 빈 검색 결과, 잘못된 입력에 대응 | 재시도, 다른 도구 사용, 오류 메시지 출력 |
| 12 | 보안 및 권한 관리 | 위험한 도구 실행과 정보 유출을 방지 | API Key 관리, 도구별 권한 제한, 승인 절차 |
5. AI Agent 개발 필요한 지식 순서
| 순위 | 요구 지식 | 이유 |
| 1 | Python 기초 | Agent와 Tool을 함수 및 클래스로 구현 |
| 2 | API 및 JSON | 외부 서비스와 LLM을 연결 |
| 3 | LLM 기본 원리 | 모델의 한계와 응답 특성 이해 |
| 4 | 프롬프트 엔지니어링 | 역할, 규칙, 출력 형식 제어 |
| 5 | Function Calling 및 Tool Calling | LLM이 적절한 도구를 호출하도록 구현 |
| 6 | Agent Workflow | 분기, 반복, 종료 조건 설계 |
| 7 | 상태 및 메모리 관리 | 중간 결과와 대화 기록 관리 |
| 8 | RAG | 문서 및 데이터 검색 기반 답변 구현 |
| 9 | 데이터베이스 | 사용자 정보, 실행 기록, 문서 저장 |
| 10 | 검색 및 재랭킹 | 관련 자료를 정확하게 선별 |
| 11 | 평가 방법 | Agent 성능을 객관적으로 측정 |
| 12 | 비동기 및 병렬 처리 | 여러 API와 도구를 효율적으로 실행 |
| 13 | 백엔드 개발 | Agent를 웹 서비스로 배포 |
| 14 | 보안 | API Key, 개인정보, 도구 권한 보호 |
| 15 | 배포 및 운영 | 로그, 비용, 장애, 버전 관리 |
6. RAM 인식을 하지 않으면 컴퓨터 화면이 안나오는 이유
컴퓨터 전원을 켜면 운영체제가 실행되기 전에 메인보드가 POST(Power-On Self-Test, 전원 공급 자기진단)를 수행합니다. 이 과정에서 CPU, RAM, 그래픽카드 등 필수 부품이 정상적으로 연결되어 있는지 확인합니다.
RAM이 제대로 인식되지 않으면 다음 순서에서 부팅이 중단됩니다.
- CPU에 전원이 공급됨
- 메인보드 BIOS 또는 UEFI가 실행됨
- 메모리 컨트롤러가 RAM을 탐색함
- RAM의 용량, 속도, 타이밍 등을 확인하고 초기화함
- RAM 초기화가 실패하면 POST가 중단됨
- 그래픽 출력 초기화와 운영체제 부팅 단계까지 진행되지 못함
따라서 모니터 자체가 고장 난 것이 아니라, 컴퓨터가 화면을 출력할 단계까지 부팅되지 못한 것입니다.
RAM 접점에 먼지나 산화물이 있거나 RAM이 슬롯에 끝까지 장착되지 않으면, 메인보드와 RAM 사이의 전기적 신호가 정상적으로 전달되지 않습니다. 특히 DDR 메모리는 많은 접점을 통해 주소, 데이터, 전압 및 제어 신호를 주고받기 때문에 일부 접점만 불안정해도 메모리 초기화가 실패할 수 있습니다.
이때 일반적으로 나타나는 현상은 다음과 같습니다.
- 전원과 팬은 작동하지만 화면이 나오지 않음
- 키보드와 마우스에 전원이 들어오지 않음
- 전원이 반복적으로 켜졌다 꺼짐
- 메인보드 DRAM 경고등이 켜짐
- 메인보드 스피커에서 메모리 오류 비프음이 발생함
즉, 팬이 돌아간다고 해서 컴퓨터 부팅이 완료된 것은 아닙니다. 팬은 단순히 전원이 공급되면 작동할 수 있지만, 화면 출력에는 CPU와 RAM을 포함한 주요 부품의 초기화가 필요합니다.
7. POST(Power-On Self-Test) 단계에서 RAM 문제가 다른 부품보다 자주 발생하는 이유
첫째, RAM은 접점 수가 많고 장착 상태에 민감합니다. 메모리 모듈에는 수백 개의 금속 접점이 있으며, 슬롯과 정확하게 맞닿아야 합니다. RAM이 조금만 덜 꽂히거나 접점에 먼지, 이물질, 산화가 생겨도 신호 전달에 실패할 수 있습니다.
둘째, RAM은 부팅 초기에 반드시 초기화되어야 하는 핵심 부품입니다. CPU가 BIOS·UEFI를 실행한 직후 메모리 용량, 속도, 전압, 타이밍을 확인하는 메모리 트레이닝을 수행합니다. 이 과정에서 오류가 발생하면 POST가 즉시 중단되므로 RAM 문제가 눈에 잘 띕니다.
셋째, RAM은 여러 부품의 설정과 동시에 영향을 받습니다. 실제 RAM 자체가 정상이어도 다음 문제로 메모리 오류가 발생할 수 있습니다.
- RAM 슬롯 불량
- CPU 소켓 핀 접촉 불량
- CPU 내부 메모리 컨트롤러 문제
- XMP·EXPO 오버클럭 설정 불안정
- 서로 다른 RAM 모듈의 혼용
- 메인보드 BIOS와 RAM의 호환성 문제
- 전압 또는 타이밍 설정 오류
즉, POST의 DRAM 오류는 반드시 RAM 모듈 자체의 고장만 의미하지는 않습니다. 메모리와 연결된 CPU, 메인보드, 슬롯 및 BIOS 설정 문제까지 RAM 오류로 나타날 수 있습니다.
넷째, RAM은 사용자가 직접 탈착하거나 증설하는 경우가 많습니다. CPU나 그래픽카드보다 교체와 추가 장착이 빈번하므로 불완전한 장착, 잘못된 슬롯 사용 및 혼용 문제가 상대적으로 많이 발생합니다.
결론적으로 POST에서 RAM 문제가 많이 나타나는 이유는 RAM이 구조적으로 접촉에 민감하고, 부팅 초기에 복잡한 초기화 과정을 거치며, CPU·메인보드·BIOS 설정 문제까지 DRAM 오류로 표시될 수 있기 때문입니다.
8. Postgre DB + Vector DB
PostgreSQL + pgvector에서는 보통 하나의 PostgreSQL 안에서 메타데이터·본문·벡터를 함께 저장하고 검색합니다.
예를 들면 한 행에 다음처럼 저장합니다.
documents
- id
- title
- content          ← 실제 문서 조각 내용
- source
- category
- created_at
- embedding        ← 문서 조각의 임베딩 벡터
질문이 들어오면 일반적인 흐름은 다음과 같습니다.
사용자 질문
→ 질문을 임베딩 벡터로 변환
→ PostgreSQL의 embedding 열과 유사도 비교
→ 유사한 문서 행을 검색
→ 해당 행의 content를 함께 가져옴
→ LLM에 질문과 content를 전달
→ 답변 생성
즉, 벡터 DB에서 문서 ID만 찾고 일반 DB에서 내용을 가져오는 구조라기보다, pgvector 검색 결과 행에서 content, title, source 등을 동시에 가져오는 방식이 일반적입니다.
SELECT
    id,
    title,
    content,
    source,
    embedding <=> :question_embedding AS distance
FROM document_chunks
ORDER BY embedding <=> :question_embedding
LIMIT 5;
여기서 다음이 한 번에 수행됩니다.
- embedding으로 질문과 가까운 문서 검색
- content로 실제 본문 반환
- title, source로 출처 정보 반환
DB와 벡터 DB의 역할
PostgreSQL을 사용할 때는 물리적으로 두 개의 별도 시스템이라기보다, 역할을 다음과 같이 구분하면 됩니다.
| 일반 DB 기능 | 제목, 날짜, 카테고리, 작성자, 권한, 본문 | SQL 조건 검색 |
| 벡터 DB 기능 | 문서 의미를 표현한 임베딩 | 코사인 거리 등 유사도 검색 |
| PostgreSQL + pgvector | 위 두 기능을 하나의 DB에서 제공 | SQL 필터와 벡터 검색 결합 |
예를 들어 사용자가 다음과 같이 질문했다고 가정할 수 있습니다.
2026년 한국 해상풍력 입찰에서 가격 외 평가항목은 무엇인가?
이때 일반 DB 조건으로는 다음 항목을 제한할 수 있습니다.
country = '한국'
year = 2026
category = '해상풍력'
그 후 제한된 문서들 안에서 질문 임베딩과 가장 유사한 문서를 찾습니다.
SELECT
    title,
    content,
    source
FROM document_chunks
WHERE country = '한국'
  AND year = 2026
  AND category = '해상풍력'
ORDER BY embedding <=> :question_embedding
LIMIT 5;
이것을 하이브리드 검색 또는 메타데이터 필터링이 결합된 벡터 검색이라고 볼 수 있습니다.
PostgreSQL + pgvector
- 문서 메타데이터
- 청크 본문
- 임베딩
핵심 정리
질문의 표현을 수정하면 다음이 더 정확합니다.
PostgreSQL의 일반 컬럼으로 문서의 조건과 메타데이터를 관리하고, pgvector 컬럼으로 질문과 의미가 비슷한 문서 조각을 검색한 뒤, 같은 행에 저장된 실제 본문을 가져온다.
벡터 검색으로 질문에 맞는 문서 조각을 찾고
일반 컬럼에서 실제 내용과 메타데이터를 가져온다
9. 쇼핑몰 사용자 추천 알고리즘 작동 원리
가장 대표적인 방식은 다음 네 가지입니다.
- 협업 필터링
사용자와 상품의 행동 기록을 이용합니다.
예를 들어:
- 사용자 A가 신발, 양말, 운동복을 구매함
- 사용자 B가 신발, 운동복을 구매함
- 그러면 사용자 B에게 양말을 추천함
여기서는 “신발을 산 사람에게 양말을 추천하라”는 정답을 사람이 직접 입력하지 않습니다. 과거 사용자들의 구매 패턴에서 자동으로 관계를 학습합니다.
사용자와 상품을 각각 벡터로 만들고, 내적이나 코사인 유사도로 선호도를 계산할 수 있습니다.
사용자 벡터
[운동용품 선호, 가격 민감도, 브랜드 선호, 계절 선호, ...]

상품 벡터
[운동 관련성, 가격대, 브랜드, 계절성, ...]
사용자 벡터와 상품 벡터가 가까우면 추천 점수가 높아집니다.
다만 실제 임베딩 차원은 “운동용품 선호”처럼 사람이 의미를 직접 붙인 값이 아니라, 모델이 학습한 잠재 요인인 경우가 많습니다.
2. 콘텐츠 기반 추천
사용자가 이전에 본 상품과 속성이 비슷한 상품을 추천합니다.
예를 들어 사용자가 다음 상품을 자주 봤다고 가정합니다.
검은색
남성용
러닝화
10만 원대
나이키
그러면 비슷한 속성을 가진 다른 운동화를 추천합니다.
이 방식에서는 상품 설명, 카테고리, 브랜드, 가격, 이미지 등을 벡터로 만들 수 있습니다.
사용자가 선호한 상품들의 벡터 평균
→ 사용자 취향 벡터

새 상품의 벡터
→ 상품 벡터

두 벡터의 유사도 계산
→ 추천 후보 선정
이것은 질문에서 말한 “사용자 상태를 벡터로 만들고 주변 상품을 찾는 방식”에 가깝습니다.
3. 지도학습 기반 추천
과거 행동을 정답으로 만들어 모델을 학습합니다.
예를 들어 한 사용자와 한 상품의 조합에 대해 다음 피처를 넣습니다.
사용자 나이
사용자 성별
최근 본 카테고리
최근 구매 상품
현재 날씨
현재 시간
상품 가격
상품 할인율
상품 카테고리
브랜드
정답은 다음과 같이 만들 수 있습니다.
클릭했으면 1
클릭하지 않았으면 0
또는:
구매했으면 1
구매하지 않았으면 0
모델은 다음 함수를 학습합니다.
사용자 정보 + 상품 정보 + 현재 상황
→ 클릭 또는 구매 확률
예를 들어 모델 출력은 다음과 같습니다.
파전 구매 확률: 0.72
우산 구매 확률: 0.65
아이스크림 구매 확률: 0.08
비 오는 날 파전이 자주 구매되었다면, 사람이 규칙을 넣지 않아도 모델이 해당 패턴을 학습할 수 있습니다.
4. 연관 규칙 기반 추천
“신발을 산 사람은 양말도 산다”와 가장 직접적으로 대응하는 방식입니다.
장바구니 데이터를 분석해서 상품 간 동시 구매 관계를 찾습니다.
신발 구매자 1,000명 중
양말도 구매한 사람 400명

신발 → 양말
대표적인 알고리즘은 다음과 같습니다.
- Apriori
- FP-Growth
- Association Rule Mining
여기서 중요한 지표는 다음과 같습니다.
- Support: 두 상품이 전체 거래에서 함께 등장하는 비율
- Confidence: 신발을 산 사람이 양말도 산 비율
- Lift: 우연한 동시 구매보다 실제 관계가 얼마나 강한지
이 방식도 사람이 “신발 → 양말”이라는 정답을 직접 주는 것이 아니라, 거래 데이터에서 규칙을 발견합니다.
“비 오는 날 파전”은 어떻게 처리하는가
세 가지 방식이 가능합니다.
첫째, 사람이 규칙을 직접 설정할 수 있습니다.
비가 온다
→ 파전과 우산 추천 점수 증가
이것은 규칙 기반 시스템입니다.
둘째, 지도학습으로 학습할 수 있습니다.
과거 데이터에 날씨와 구매 기록이 있다면:
날씨 = 비
상품 = 파전
구매 여부 = 1
같은 사례가 누적됩니다. 모델은 비가 올 때 파전 구매 확률이 높아지는 패턴을 학습합니다.
셋째, 통계적 연관성을 계산할 수 있습니다.
비 오는 날 파전 구매율
맑은 날 파전 구매율
두 비율을 비교해 비 오는 날 파전 구매가 실제로 증가하는지 확인합니다.
실제 쇼핑몰에서는 어떻게 결합하는가
일반적인 추천 시스템은 다음처럼 구성됩니다.
1단계: 후보 생성
협업 필터링, 벡터 유사도, 인기 상품 등으로
수백만 개 상품 중 수백 개를 추림

2단계: 순위화
지도학습 또는 딥러닝 모델로
각 상품의 클릭·구매 확률 계산

3단계: 후처리
재고, 배송 가능 여부, 광고, 중복, 다양성 등을 반영

4단계: 최종 추천
점수가 높은 상품을 사용자에게 노출
예를 들어:
전체 상품: 1,000,000개
→ 벡터 유사도와 협업 필터링으로 500개 후보
→ 지도학습 모델로 구매 확률 예측
→ 재고 없는 상품 제거
→ 동일 브랜드 과다 노출 방지
→ 최종 20개 추천
따라서 벡터 유사도는 주로 후보를 빠르게 찾는 데 사용되고, 지도학습 모델은 후보들의 최종 순서를 정하는 데 많이 사용됩니다.
정답 데이터는 누가 만드는가
추천 시스템에서는 사람이 정답을 하나씩 작성하지 않는 경우가 대부분입니다. 사용자의 행동 자체를 정답처럼 사용합니다.
노출했는가
클릭했는가
장바구니에 넣었는가
구매했는가
찜했는가
오래 보았는가
반품했는가
예를 들어 가중치를 줄 수도 있습니다.
상품 노출: 0
클릭: 1
찜: 2
장바구니: 3
구매: 5
반품: -3
별점처럼 사용자가 직접 선호도를 입력하면 명시적 피드백입니다.
핵심 차이
| 벡터 유사도 | 사용자와 상품의 표현 벡터 | 러닝화를 본 사용자에게 비슷한 러닝화 추천 |
| 협업 필터링 | 비슷한 사용자들의 행동 | 나와 구매 패턴이 비슷한 사람이 산 상품 추천 |
| 지도학습 | 과거 클릭·구매 결과 | 이 사용자가 이 상품을 구매할 확률 예측 |
| 연관 규칙 | 함께 구매된 상품 조합 | 신발 구매자에게 양말 추천 |
| 규칙 기반 | 사람이 정의한 조건 | 비 오는 날 우산 추천 |
결론적으로, 쇼핑몰 추천 알고리즘은 “사용자 벡터 주변 상품을 찾는 방식”도 맞고, “과거 구매 여부를 정답으로 학습하는 지도학습 방식”도 맞습니다.
벡터·협업 필터링으로 추천 후보 생성
→ 지도학습 모델로 클릭·구매 확률 계산
→ 재고와 비즈니스 규칙으로 최종 정렬